Scripts Examples
These are the bundled script examples.
Convert to yyyy-MM-dd|hh:mm:ss
Convert date/time strings to yyyy-MM-dd|hh:mm:ss.
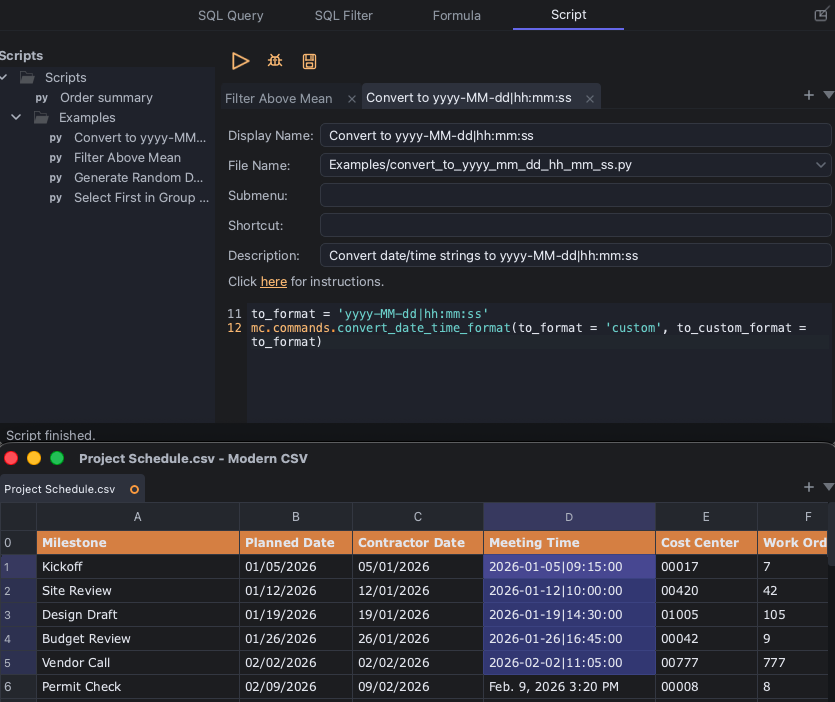
This runs Convert Date/Time Format. The script defines the output format, and the launcher asks for the current format. You can write a similar script the other way around by defining the input format and asking for the output format.
import numpy as np
import moderncsv.scripts as mc

COMMAND = {
    "id": "convert_to_yyyy_mm_dd_hh_mm_ss",
    "name": "Convert to yyyy-MM-dd|hh:mm:ss",
    "description": "Convert date/time strings to yyyy-MM-dd|hh:mm:ss",
}

def run(mc):
    to_format = 'yyyy-MM-dd|hh:mm:ss'
    mc.commands.convert_date_time_format(to_format = 'custom', to_custom_format = to_format)
Filter Above Mean
Computes the mean of the selected column and filters in every row whose value exceeds the mean.
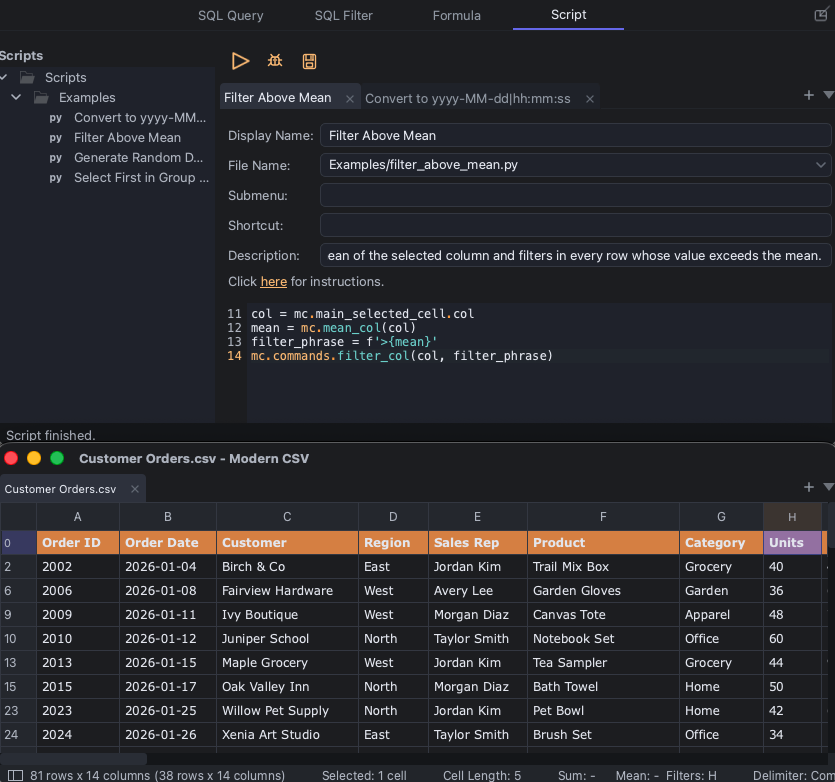
Only rows whose value in the selected column is above the mean remain visible.
import numpy as np
import moderncsv.scripts as mc

COMMAND = {
    "id": "filter_above_mean",
    "name": "Filter Above Mean",
    "description": "Computes mean of the selected column and filters in every row whose value exceeds the mean.",
}

def run(mc):
    col = mc.main_selected_cell.col
    values = mc.col(col)
    mean = mc.mean(values)
    filter_phrase = f'>{mean}'
    mc.commands.filter_col(col, filter_phrase)
Generate Random Data by Distribution
Fill a column with random data according to a distribution and parameters.
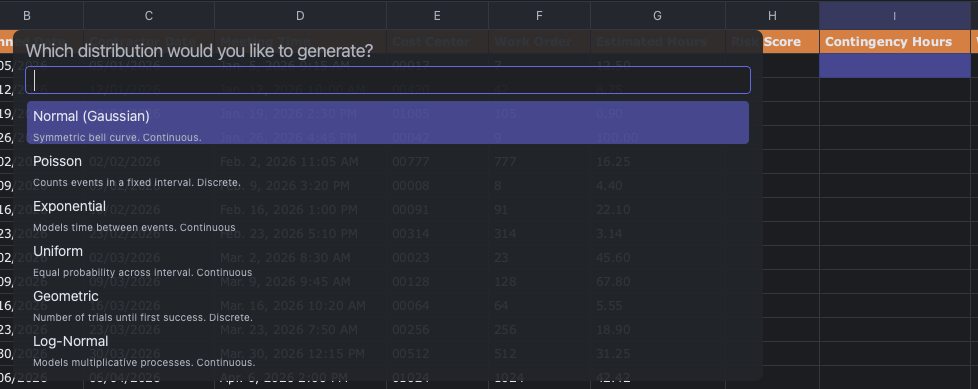
This pops up Launcher prompts asking which distribution to use, the distribution parameters, the sample count, and where to write the result.
import numpy as np
import moderncsv.scripts as mc

COMMAND = {
    "id": "make_random_data_by_distribution",
    "name": "Generate Random Data by Distribution",
    "description": "Fill a column with random data according to some distribution and parameters",
}

def run(mc):
    def _is_positive_float(text):
        return float(text) > 0

    def _is_non_negative_float(text):
        return float(text) >= 0

    def _is_probability(text):
        probability = float(text)
        return 0 < probability <= 1

    def _is_non_negative_int(text):
        return int(text) >= 0

    def _is_positive_int(text):
        return int(text) > 0

    default_sample_count = mc.row_count('physical')
    if default_sample_count == 0:
        default_sample_count = 50
    default_sample_count = max(0, default_sample_count - mc.num_header_rows)

    uniform_state = {'minimum': None}

    def validate_uniform_minimum(text):
        uniform_state['minimum'] = float(text)
        return True

    def validate_uniform_maximum(text):
        maximum = float(text)
        minimum = uniform_state['minimum']
        return minimum is None or maximum >= minimum

    # Ask which distribution to use.
    distribution_options = [
        mc.QueryOption('Normal (Gaussian)',
            description = 'Symmetric bell curve. Continuous.',
            option_id = 'normal',
        ),
        mc.QueryOption('Poisson',
            description = 'Counts events in a fixed interval. Discrete.',
            option_id = 'poisson',
        ),
        mc.QueryOption('Exponential',
            description = 'Models time between events. Continuous',
            option_id = 'exponential',
        ),
        mc.QueryOption('Uniform',
            description = 'Equal probability across interval. Continuous',
            option_id = 'uniform',
        ),
        mc.QueryOption('Geometric',
            description = 'Number of trials until first success. Discrete.',
            option_id = 'geometric',
        ),
        mc.QueryOption('Log-Normal',
            description = 'Models multiplicative processes. Continuous.',
            option_id = 'log_normal',
        ),
    ]

    distribution_query = mc.QueryData(
        query_id = 'distribution-query',
        title = 'Which distribution would you like to generate?',
        options = distribution_options,
        response_map = {
            'normal': 'normal-param1',
            'poisson': 'poisson-param1',
            'exponential': 'exponential-param1',
            'uniform': 'uniform-param1',
            'geometric': 'geometric-param1',
            'log_normal': 'log-normal-param1',
        }
    )

    # Normal distribution parameters
    normal_param1_query = mc.QueryData(
        query_id = 'normal-param1',
        title = 'Enter mean (μ):',
        description = 'Any number.',
        input_type = mc.InputType.FLOAT,
        next_query_id = 'normal-param2'
    )

    normal_param2_query = mc.QueryData(
        query_id = 'normal-param2',
        title = 'Enter standard deviation (σ):',
        description = 'A number greater than 0.',
        input_type = mc.InputType.FLOAT,
        validator = _is_positive_float,
        validator_error_message = 'Enter a number greater than 0.',
        next_query_id = 'sample-count-query'
    )

    # Poisson distribution parameters
    poisson_param1_query = mc.QueryData(
        query_id = 'poisson-param1',
        title = 'Enter rate / expected count (λ):',
        description = 'A number greater than or equal to 0.',
        input_type = mc.InputType.FLOAT,
        validator = _is_non_negative_float,
        validator_error_message = 'Enter a number greater than or equal to 0.',
        next_query_id = 'sample-count-query'
    )

    # Exponential distribution parameters
    exponential_param1_query = mc.QueryData(
        query_id = 'exponential-param1',
        title = 'Enter scale (β):',
        description = 'A number greater than 0.',
        input_type = mc.InputType.FLOAT,
        validator = _is_positive_float,
        validator_error_message = 'Enter a number greater than 0.',
        next_query_id = 'sample-count-query'
    )

    # Uniform distribution parameters
    uniform_param1_query = mc.QueryData(
        query_id = 'uniform-param1',
        title = 'Enter minimum value:',
        description = 'Any number.',
        input_type = mc.InputType.FLOAT,
        validator = validate_uniform_minimum,
        next_query_id = 'uniform-param2'
    )

    uniform_param2_query = mc.QueryData(
        query_id = 'uniform-param2',
        title = 'Enter maximum value:',
        description = 'Any number greater than or equal to the minimum value.',
        input_type = mc.InputType.FLOAT,
        validator = validate_uniform_maximum,
        validator_error_message = 'Enter a number greater than or equal to the minimum value.',
        next_query_id = 'sample-count-query'
    )

    # Geometric distribution parameters
    geometric_param1_query = mc.QueryData(
        query_id = 'geometric-param1',
        title = 'Enter probability of success (p):',
        description = 'A number between 0 and 1 (including 1, not including 0).',
        input_type = mc.InputType.FLOAT,
        validator = _is_probability,
        validator_error_message = 'Enter a number greater than 0 and less than or equal to 1.',
        next_query_id = 'sample-count-query'
    )

    # Log-normal distribution parameters
    log_normal_param1_query = mc.QueryData(
        query_id = 'log-normal-param1',
        title = 'Enter mean of underlying normal distribution (μ):',
        description = 'Any number.',
        input_type = mc.InputType.FLOAT,
        next_query_id = 'log-normal-param2'
    )

    log_normal_param2_query = mc.QueryData(
        query_id = 'log-normal-param2',
        title = 'Enter standard deviation of underlying normal distribution (σ):',
        description = 'A number greater than 0.',
        input_type = mc.InputType.FLOAT,
        validator = _is_positive_float,
        validator_error_message = 'Enter a number greater than 0.',
        next_query_id = 'sample-count-query'
    )

    sample_count_query = mc.QueryData(
        query_id = 'sample-count-query',
        title = 'How many samples would you like to include?',
        description = 'A whole number greater than or equal to 0.',
        input_type = mc.InputType.INT,
        validator = _is_positive_int,
        validator_error_message = 'Enter a whole number greater than or equal to 0.',
        editor_text = str(default_sample_count),
        editor_select_all = True,
        next_query_id = 'where-to-write-query'
    )

    # Ask whether to insert a column or overwrite the current one.
    where_to_write_query = mc.QueryData(
        query_id = 'where-to-write-query',
        title = 'Where would you like to put the data?',
        options = [
            mc.QueryOption('Insert new column', option_id = 'insert_new_col'),
            mc.QueryOption('Overwrite current column', option_id = 'overwrite_current_col'),
        ]
    )

    # Run the queries.
    query_list = [
        distribution_query,
        normal_param1_query,
        normal_param2_query,
        poisson_param1_query,
        exponential_param1_query,
        uniform_param1_query,
        uniform_param2_query,
        geometric_param1_query,
        log_normal_param1_query,
        log_normal_param2_query,
        sample_count_query,
        where_to_write_query
    ]
    responses = mc.run_queries(query_list)
    if responses is None:
        return

    # Generate the data (x).
    rng = np.random.default_rng()

    N = int(responses['sample-count-query'])
    dist = responses['distribution-query']
    if dist == 'normal':
        mean = float(responses['normal-param1'])
        sigma = float(responses['normal-param2'])

        x = rng.normal(loc = mean, scale = sigma, size = N)

    elif dist == 'poisson':
        lam = float(responses['poisson-param1'])
        x = rng.poisson(lam = lam, size = N)

    elif dist == 'exponential':
        scale = float(responses['exponential-param1'])
        x = rng.exponential(scale = scale, size = N)

    elif dist == 'uniform':
        minimum = float(responses['uniform-param1'])
        maximum = float(responses['uniform-param2'])
        x = rng.uniform(low = minimum, high = maximum, size = N)

    elif dist == 'geometric':
        probability = float(responses['geometric-param1'])
        x = rng.geometric(p = probability, size = N)

    elif dist == 'log_normal':
        mean = float(responses['log-normal-param1'])
        sigma = float(responses['log-normal-param2'])
        x = rng.lognormal(mean = mean, sigma = sigma, size = N)

    else:
        raise ValueError(f'Unsupported distribution: {dist}')

    # Write the data.
    col = mc.main_selected_cell.col
    where_to_write = responses['where-to-write-query']
    if where_to_write == 'insert_new_col':
        mc.edit.insert_cols(col)
    mc.edit.set_cell(mc.num_header_rows, col, x)
Select First in Group Based on Main Selected Column
Going down the main selected cell's column, every time a cell value differs from the previous, select it.
import numpy as np
import moderncsv.scripts as mc

COMMAND = {
    "id": "select_first_in_group_based_on_main_selected_column",
    "name": "Select First in Group Based on Main Selected Column",
    "description": "Going down the main selected cell's column, every time a cell value differs from the previous, select it.",
}

def run(mc):
    def values_match(left, right):
        if isinstance(left, (float, np.floating)) and isinstance(right, (float, np.floating)):
            if np.isnan(left) and np.isnan(right):
                return True

        return left == right

    col = mc.main_selected_cell.col
    values = mc.col(col)

    if len(values) == 0:
        return

    first_data_row = mc.num_header_rows
    selected_cells = []
    previous_value = None
    has_previous_value = False

    for offset, value in enumerate(values):
        if not has_previous_value or not values_match(value, previous_value):
            selected_cells.append(mc.Range(first_data_row + offset, col))

        previous_value = value
        has_previous_value = True

    mc.edit.set_selection(mc.RangeList(selected_cells))